
QA Agent Supervisor
Un système multi-agents qui pilote une vraie suite de tests Playwright/pytest pour un site e-commerce. Il suggère des pistes de couverture, exécute les tests, trie les échecs et rédige le rapport, sans jamais écrire de code de test lui-même.
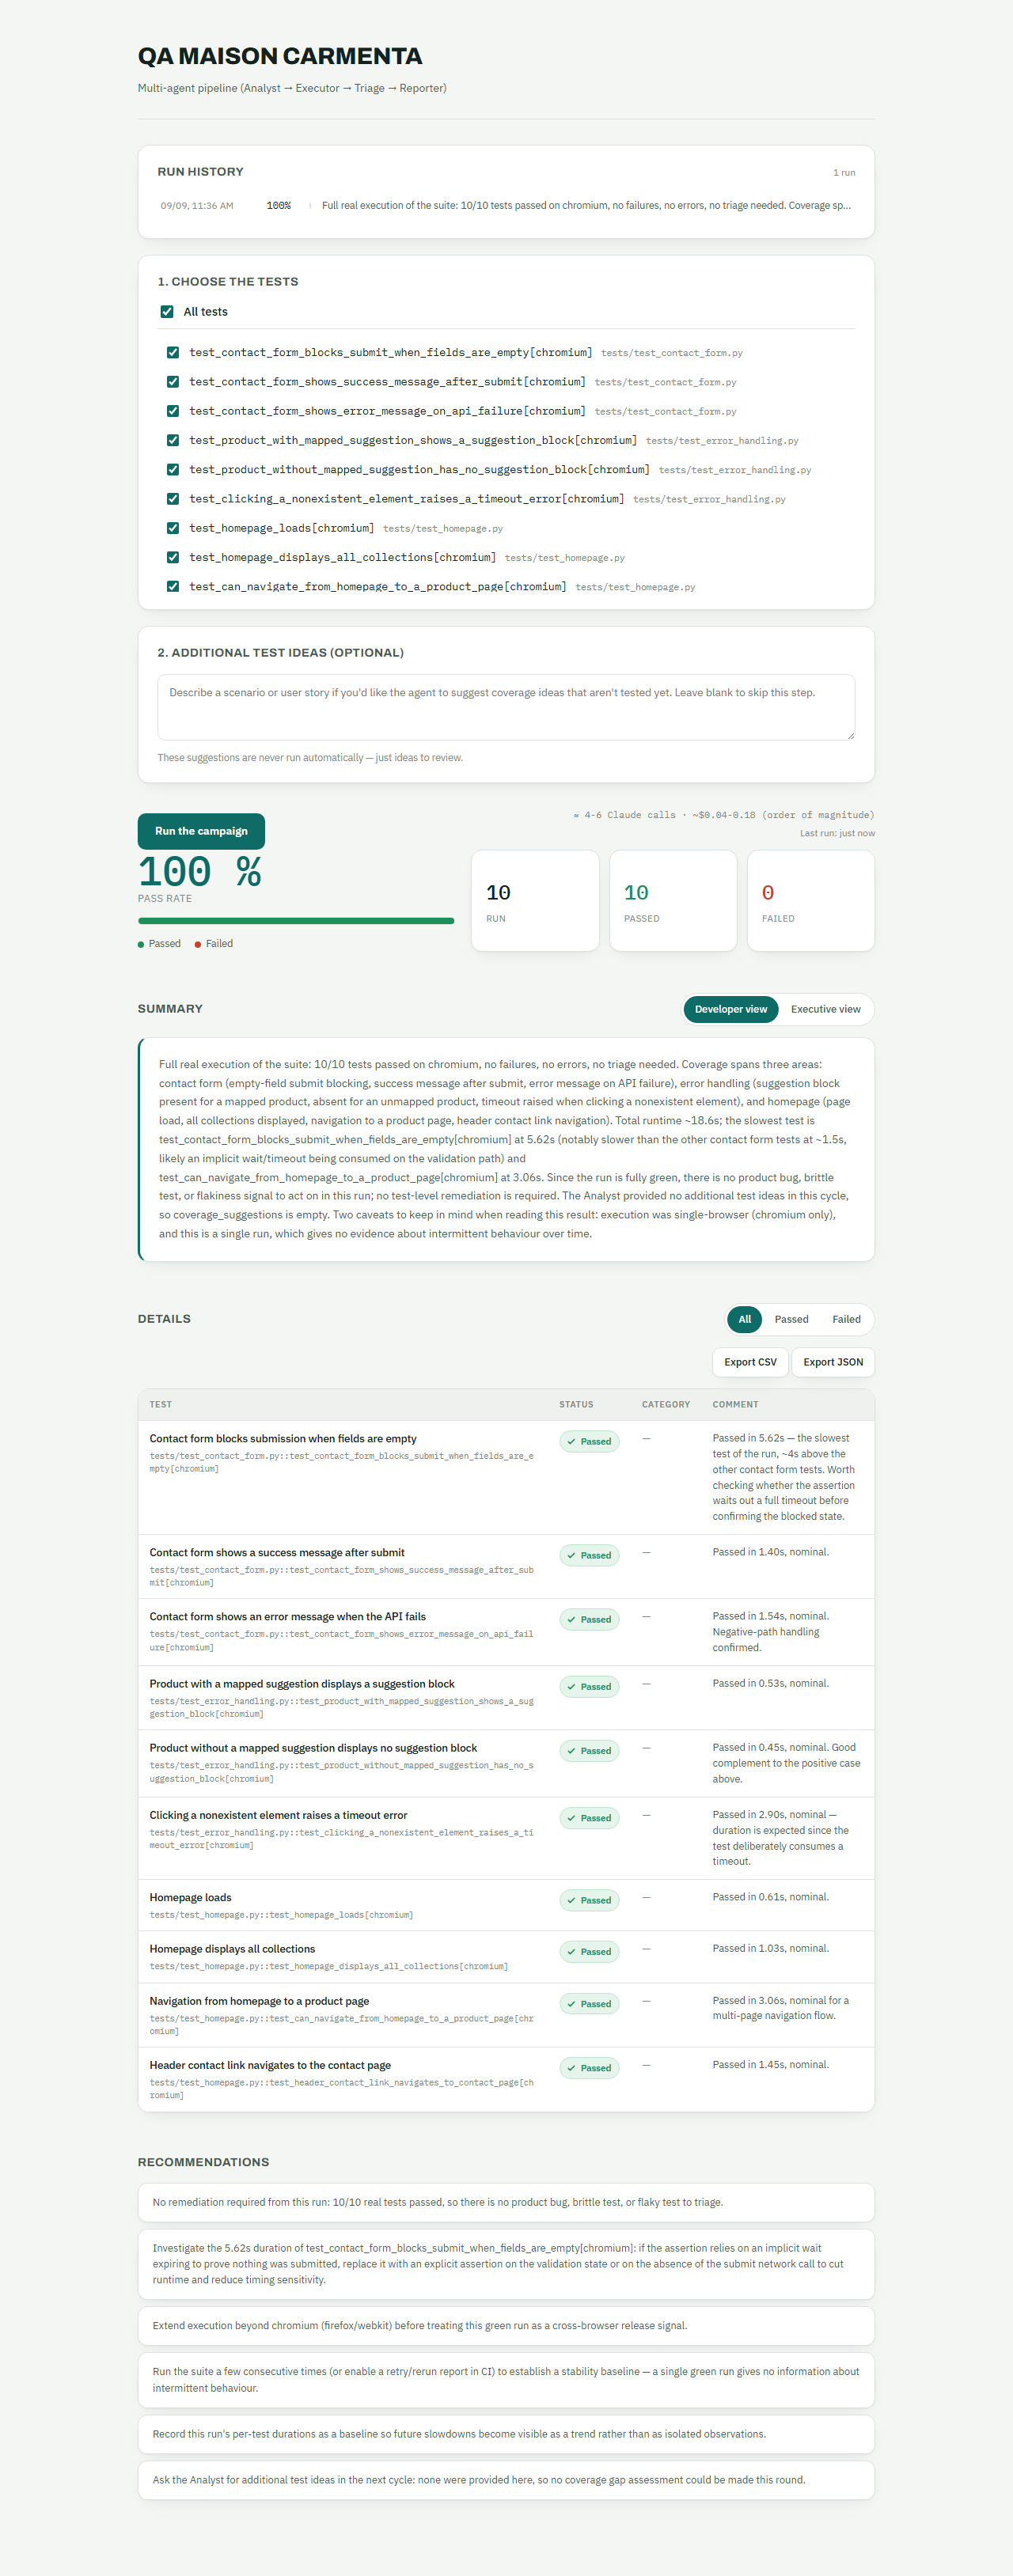
Vue d'ensemble
Le problème
Une suite de tests Playwright/pytest génère des échecs, mais il faut un humain pour trier : bug produit, test fragile, flaky, ou souci d'environnement. Faire générer le code de test à la volée par une IA a été essayé, puis abandonné : le résultat était trop instable pour qu'on puisse s'y fier.
L'approche
Un agent Supervisor route chaque demande vers l'un des 4 agents spécialisés via LangGraph. Chaque agent a un rôle unique et une sortie typée (Pydantic), garantie par Claude Structured Outputs plutôt que par du parsing de texte libre.
La rigueur
Un test n'est classé flaky que s'il échoue puis réussit dans le même run (via pytest-rerunfailures), jamais par une estimation basée sur son historique. Seuls les échecs qui persistent après ce rerun déclenchent un appel à Claude.
Architecture
Pattern Supervisor (LangGraph)
Un nœud central (le Supervisor) reçoit chaque demande et la route vers l'un des 4 agents spécialisés en fonction de son type. Chaque agent communique via des sorties structurées Pydantic, garanties par Claude Structured Outputs : aucun agent ne parse du texte libre produit par un autre.
Le Supervisor route chaque requête vers l'agent spécialisé approprié
Analyst
Suggère des pistes de couverture non testées à partir d'une spec en langage naturel, en vérifiant la liste réelle des tests existants pour ne jamais dupliquer une couverture déjà présente.
Executor
Lance la vraie suite pytest en sous-processus et parse le JUnit XML produit, y compris le texte complet des erreurs, pas seulement un résumé tronqué.
Triage
Catégorise chaque échec : bug produit, test fragile, flaky ou environnement. Les tests réparés après rerun sont classés "flaky" par preuve directe, sans appel LLM ; seuls les échecs persistants passent par Claude.
Reporter
Produit un rapport à deux niveaux : un rapport technique complet pour les équipes dev/QA, et une synthèse en 3 phrases sans jargon pour les non-techniques.
Interface web
- Sélection de tests et lancement asynchrone des runs
- Bouton Stop qui arrête réellement le sous-processus pytest en cours (vérifié en direct : réponse en ~45 ms)
- Historique des runs et export CSV/JSON
- Estimation de coût avant lancement d'un run
Stack Technique
Agents & IA
- Python 3.13 - Langage principal
- LangGraph 1.2.11 - Orchestration multi-agents (pattern Supervisor)
- Claude API (claude-opus-5) - via
messages.parse()avec sortie typée - Prompt caching -
cache_control: ephemeralsur les system prompts - Pydantic 2.13 - Contrat de données typé entre agents
Backend & Interface
- FastAPI + Uvicorn - API
- JavaScript / HTML vanilla - Frontend, sans framework
Tests sous orchestration
- pytest + pytest-rerunfailures - Suite Playwright réelle (projet séparé)
- JUnit XML - Format d'échange des résultats de test
Qualité & CI
- 81 tests automatisés sur les agents eux-mêmes, 100% mockés
- GitHub Actions - CI sans secret requis
Métriques réelles
Une question sur l'architecture ?
Le code complet, y compris les décisions d'architecture et les approches abandonnées, est documenté dans le README du repo.